AI画像検査の5つの方式 ーInspection Designerはどこが違うのかー
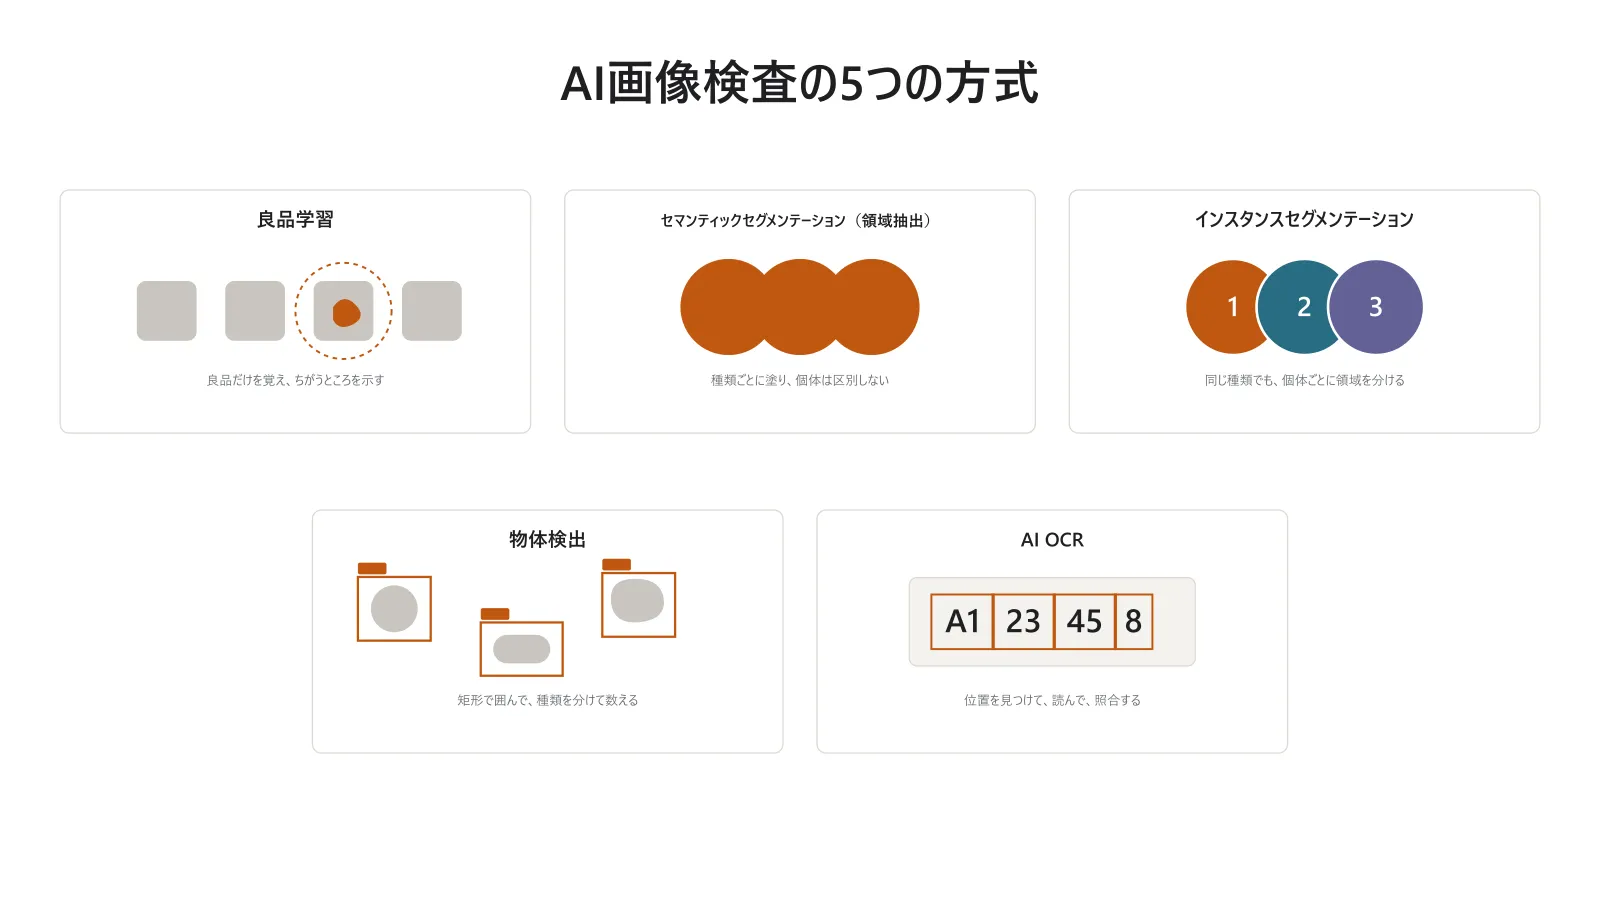
画像検査にAIを使うとき、結果を大きく左右するのは「どの方式を選ぶか」です。見つけたいものが部品なのか、広がりのあるムラなのか、文字なのか、それとも「何が起きるか分からない異常」なのかで、適した方式はまったく違います。
Inspection Designer のAIは2つの系統に分かれています。学習データが要らないゼロ学習AI(ゼロ学習異常検知・ゼロ学習物体検出・ゼロ学習領域抽出)と、学習データから学ぶ従来型AI検査です。前者は考え方が大きく違うので、製品ページのゼロ学習AIの紹介で別に説明しています。
この記事で扱うのは後者、良品学習・セマンティックセグメンテーション(領域抽出)・インスタンスセグメンテーション・物体検出・OCRという5つの考え方です。いずれもどのメーカーも同じ名前で提供している方式なので、名前を並べただけでは違いが伝わりません。方式ごとに「何ができるのか」と「一般的な画像検査と何が違うのか」を説明します。
5つの方式で、何が違うのか
まず、AIが何を出力するかで整理すると選びやすくなります。
| 方式 | 主な出力 | 検査の例 |
|---|---|---|
| 良品学習 | 良品と異なる箇所・異常度 | 不良の種類を列挙しにくい外観検査 |
| セマンティックセグメンテーション(領域抽出) | 種類ごとの画素領域 | 錆・変色・接着剤の広がりや面積 |
| インスタンスセグメンテーション | 個体ごとの画素領域 | 接した部品の個数と、1個ずつの面積 |
| 物体検出 | 対象ごとの矩形・種類 | 部品の有無・位置・個数 |
| OCR | 文字の位置・読み取り結果 | 製造日・シリアル番号の照合 |
セマンティックとインスタンスは、どちらも画素単位の領域を出す方式です。違いは、同じ種類の対象を1個ずつ区別するかどうかです。
良品学習 — 不良品の画像が集まらなくても始められる
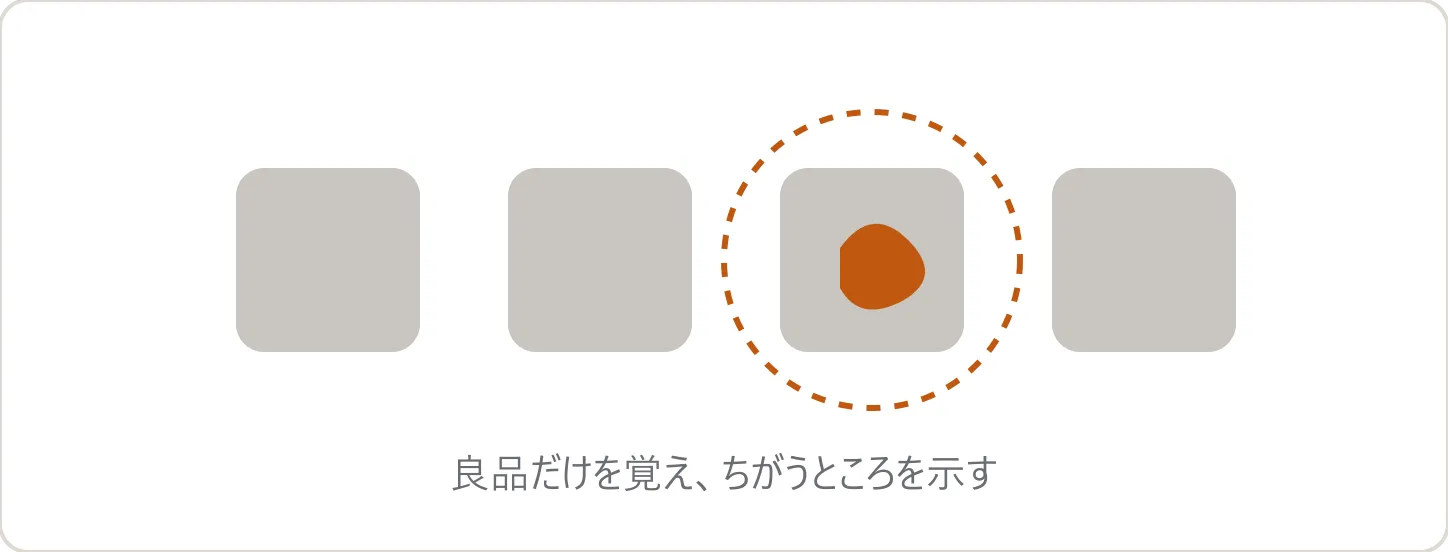
良品だけを教え、良品らしくないところを異常として示す方式です。何を異常と呼ぶかを事前に決めなくてよいのが最大の利点で、想定していなかった異常も拾えます。不良の種類を挙げきれない工程や、不良品の画像がまだ集まっていない立ち上げ期に向きます。欠陥を囲むアノテーションも要りません。
一方で、この方式は異常の種類を区別できません。また見た目をそのまま覚えるため、位置や向きがばらつくとその差まで異常として出ます。写り方を揃える工夫(位置補正や搬送側の作り込み)と組み合わせる前提の方式だと理解しておくと、立ち上げが速くなります。
この「ばらつきが異常に見えてしまう」問題に、Inspection Designer は領域ごとにしきい値を変えられることで対応しています。画像全体を同じ基準で見るのではなく、場所ごとに厳しさを変えられるということです。たとえばロット印字のまわりは個体ごとに見た目が変わりますが、そこだけ基準を緩め、ほかの面は厳しいままにできます。ばらつきの大きい部分があるという理由だけで良品学習をあきらめる必要がなくなります。
検出できる大きさは、最小で2ピクセルの欠陥までです。大きな画像の中の微細な不良でも、検出したい最小の不良サイズを指定すれば対応できます。処理時間は画素数によりますが、数十msecでの検査にも対応します。
セマンティックセグメンテーション(領域抽出) — 種類ごとの広がりを見る
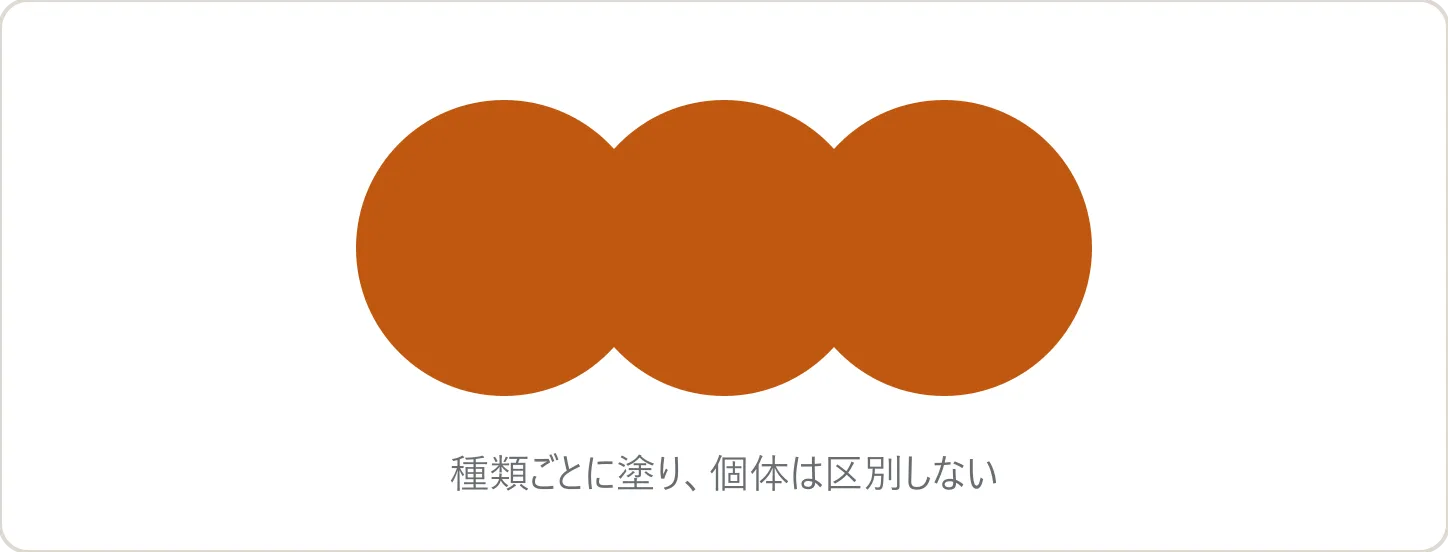
画像の各画素を、錆・変色・接着剤などの種類ごとに塗り分ける方式です。従来の記事で「領域抽出」と呼んでいた方式がこれに当たります。形の定まらないムラや塗布範囲など、広がりや面積を調べる検査に向きます。
出力には種類の情報があり、同じ種類の対象を区別する個体番号はありません。たとえば2つの錆の領域が接していれば、同じ「錆」の領域としてつながります。離れた領域を後処理で数えることはできますが、その数が実際の個体数と一致するとは限りません。
種類ごとの面積や広がりを測りたいときに選ぶ方式です。同じ種類でも1個ずつ分けて測りたい場合は、次のインスタンスセグメンテーションを使います。
インスタンスセグメンテーション — 個体ごとの形を取り出す
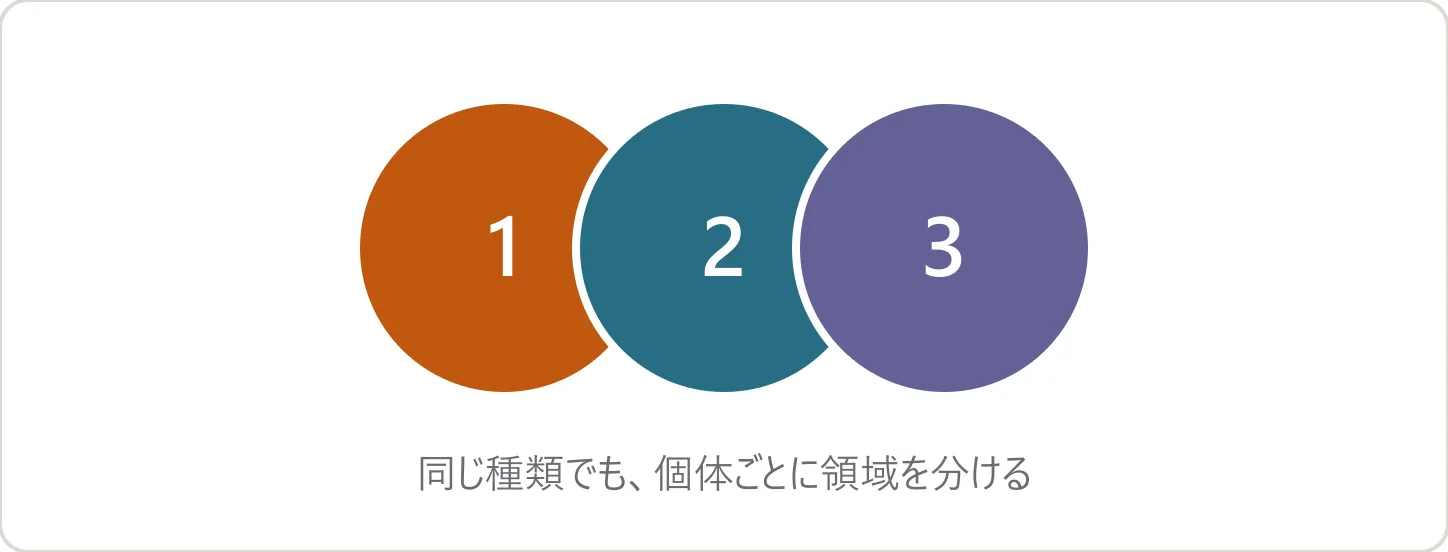
対象の種類に加えて、個体ごとに別々の領域を出す方式です。同じ種類の部品が並んでいても、「部品1」「部品2」のように区別して扱います。
セマンティックが「この画素は何の種類か」を示すのに対し、インスタンスは「どの個体に属する画素か」まで区別します。接している対象や重なった対象を分けて検出し、個数と1個ずつの面積・形状を確認したい検査に向きます。
物体検出も個体ごとに出力しますが、出すのは矩形です。個数や位置に加えて、対象の形に沿った領域が必要ならインスタンスセグメンテーションを選びます。以前の記事で物体検出の説明に含めていた「個体ごとの領域を取り出す」機能は、この方式として区別します。
セマンティックとの違いを、同じ部品で考える
同じ種類の部品が3つ、互いに接して並んでいるとします。セマンティックでは、3つとも同じ「部品」という種類の領域になります。インスタンスでは、各部品を別の領域として区別します。
部品が画像のどれだけの面積を占めるかを調べたいならセマンティック、3個あることとそれぞれの面積を確かめたいならインスタンス、という使い分けです。「種類ごと」と「個体ごと」の違いが、後段で何を測れるかにつながります。
物体検出 — どこに、何が、いくつあるか
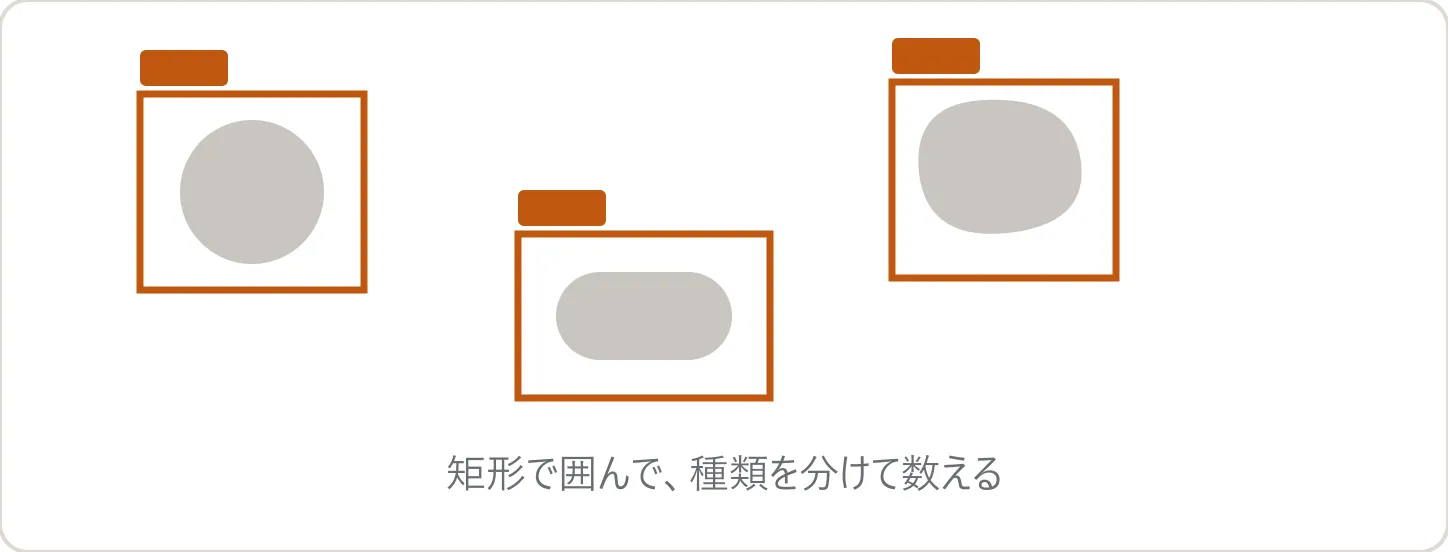
対象を矩形で囲み、種類と位置を出す方式です。部品の有無や個数、コネクタの挿し忘れ、異物の混入など、何がどこにあるかを調べる検査に向きます。
出力する矩形には対象以外の背景も含まれます。矩形の幅や高さは分かりますが、それを対象そのものの面積や輪郭として扱うことはできません。対象の形に沿って面積を測る場合は、インスタンスセグメンテーションを選びます。
Inspection Designerでは、異常部を四角で囲んで学習用のアノテーションを作成します。対象ごとの矩形で足りる検査なのか、画素単位の領域まで必要な検査なのかを分けて考えると、方式を選びやすくなります。
OCR — 読めるだけでなく、直せる
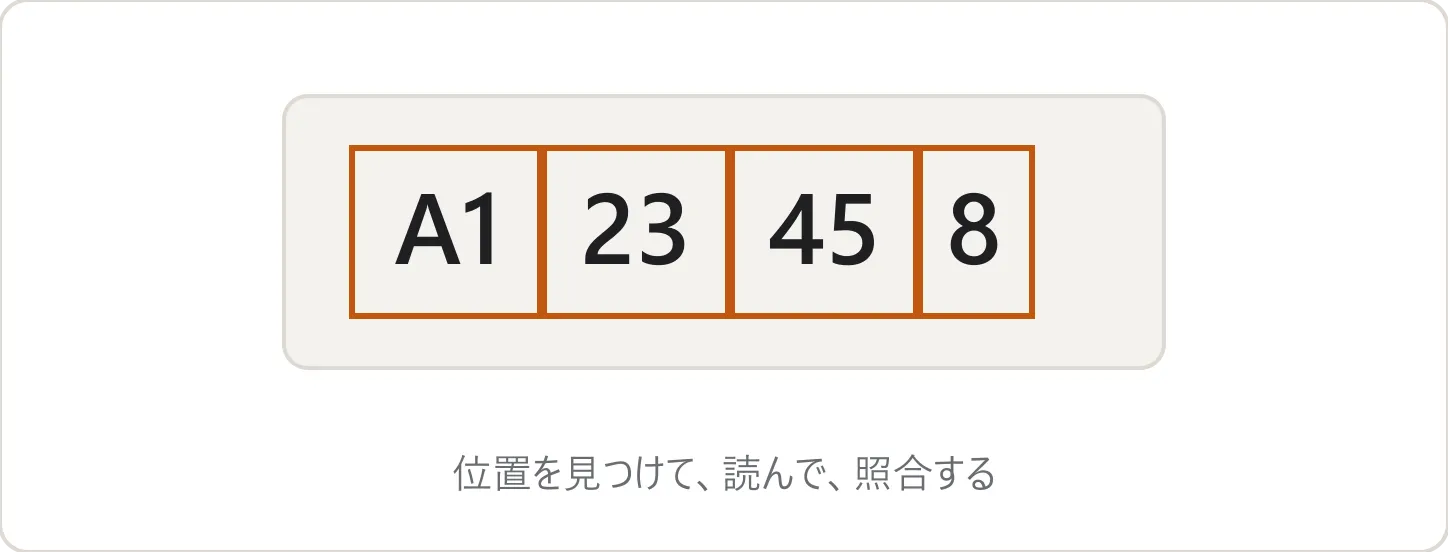
製造日やシリアル番号、ラベル文字の確認に使う文字読み取りです。
文字読み取りは、内蔵の辞書やモデルで読めない字が出たときに手が止まりがちです。刻印、かすれ、独自フォント、下地の模様に埋もれた文字などが典型で、「調整できる範囲を超えたらそこで終わり」になりやすい領域です。
Inspection Designer のOCRは2つの部分でできています。文字の位置を見つける部分と、見つけた位置の文字を読む部分で、どちらも現場の画像で学習できます。 読み違いは読む側の学習で直り、「そもそも拾えない」「余計な場所を拾う」は位置を見つける側の学習で直ります。しきい値も2段に分かれているので、「文字が全く反応しない」のか「余計な文字が混じる」のかで調整する場所が決まります。
文字のアノテーションには専用のツールを用意しています。 欠陥を囲む作業と文字を打ち込む作業は性質が違うので、他の方式と同じ画面では操作しづらいからです。進め方は2通りあります。
- AIに任せる — 文字の位置と読みの候補をAIが出し、人は間違っているところだけを直す
- 位置だけ人が決める — 読ませたい場所を人が指定し、そこに何と書いてあるかだけAIに推測させて、人が直す
学習中の成績は「位置の重なり」「文字の一致」「位置と文字の両方の一致」の3つに分けて表示します。次に直すのが位置なのか読みなのかが、数字を見れば分かります。
合否の付け方は、完全一致・部分一致・正規表現一致・文字数の4通りから選び、複数の条件を同時に満たすよう組み合わせられます。
5方式に共通する、本当の違い
方式の数をそろえているソフトウェアは他にもあります。Inspection Designer が力を入れているのは、選んだ方式を「現場で使える状態まで仕上げる」部分です。ここは大きく4つに分かれます。精度をどう確かめるか、立ち上げにどれだけ時間がかかるか、現場でどれだけ速く動くか、そして方式をどう組み合わせられるかです。
1. 精度を「確かめる」ための仕組み
精度は、上げる前に正しく測れている必要があります。測り方が粗いと、良くなったつもりで現場に出してしまいます。
領域単位まで見られること。 画像単位の正解率だけを見ていると、1枚の中にある欠陥を1つ見つけただけで「正解」になり、見逃した欠陥が数字に出ません。実際に当社で評価したデータでは、画像単位では全ての不良品を検出できているのに、領域単位で見るとどのしきい値でも4箇所が未検出のままでした。領域で数える軸があって初めて分かる情報です。
しきい値の候補が出ること。 見逃しが最も少ない点、過検出が最も少ない点、その中間のバランス点を提示し、それぞれを採用したときの判定画像まで確認できます。バランス点は「見逃し1件を過検出何件ぶんと見るか」を数で指定して決められます。検査では見逃しのほうが損失が大きいことが多いため、初期値は見逃しを重く見る設定にしています。
新旧のモデルを並べて比べられること。 学習したモデルと、いま運用に入っているモデルを同じ条件で続けて評価し、結果をタブで切り替えて見比べられます。入れ替える前に実力を確かめられるということです。
2. 立ち上げにかかる時間
検査を立ち上げる工数の多くは、AIそのものではなく工程の行き来に消えます。
集める・学習する・精度を確かめるが1つのアプリで完結します。 同じデータセットに学習用と評価用のタグを付けて管理し、学習したモデルをその場で評価にかけられます。ソフトウェアを立ち上げ直す必要がありません。
学習を「長く回す」必要がありません。 学習の途中で、学習に使っていない画像での見分け力を測ります。伸びなくなった時点で打ち切り、最も性能が高かった時点のモデルを残します。損失(Loss)の下がり方ではなく見分け力で判断するため、「学習は進んでいるのに不良が見分けられない」状態に時間を使わずに済みます。
3. 現場で出せる速さ
ラインのタクトに収まらなければ、どれだけ精度が高くても使えません。
様々な手法を組み合わせて、現場に必要な速さを出しています。 実用上の分かれ目になるのは、AIを重ねたときに速度を保てるかどうかです。たとえば物体検出とゼロ学習AIを組み合わせた構成で、300msecを下回った実績があります。精度を上げるために方式を足すと間に合わなくなる、という事態を避けられます。
4. 方式を組み合わせる自由度
1つの方式で通そうとすると、たいていどこかで無理が出ます。
前の方式が見つけた場所を、次の方式に渡せます。 たとえば良品学習は「いつもと違う」ところを見つけられますが、それが何の異常なのかまでは区別できません。見つかった場所を物体検出に渡せば、そこに何があるのかを種類に分けられます。見つけることと、種類を判別することを分担させるという考え方です。
ほかにも、領域抽出で対象の外側を消してから検査する、といった組み方ができます。位置ずれや背景の写り込みを前段で落としておけば、後段の方式が本来の仕事に集中できます。こうした組み方を、処理モジュールを線でつなぐ操作だけで作れます。
方式を選び直せること自体が価値になる
画像検査の立ち上げで時間を取られるのは、たいてい「どの方式なら取れるのか」が分からないままデータを集め始めてしまう場面です。見込みのありそうな方式で試し、精度を領域単位で確かめてしきい値を決め、足りなければ別の方式に替える。この行き来を同じソフトウェアの中で何度でも繰り返せることが、Inspection Designer のいちばんの特徴です。
どの方式が向くかは、実際の検査対象で試してみないと分かりません。事前検証は初回無償で、まず30分ほどの打ち合わせから始めます。